All Formats & Editions
1 - 1 of 1 results found
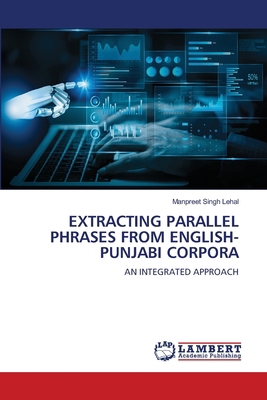
Extracting Parallel Phrases from English-Punjab...
Edition Description
This study presents a novel approach to extract parallel data from a comparable English-Punjabi corpus, addressing the scarcity of parallel corpora for this language pair. Unlike previous research, this approach focuses on creating high-precision parallel data using minimal resources...
Edition Details
Format:Paperback
Language:English
ISBN:6208225418
Format: Paperback
Condition:
$
80.84
Save $4.16!
List Price: $85.00
Copyright © 2026 Thriftbooks.com
Terms of Use | Privacy Policy | Do Not Sell/Share My Personal Information | Cookie Policy | Cookie Preferences | Accessibility Statement
ThriftBooks ® and the ThriftBooks ® logo are registered trademarks of Thrift Books Global, LLC
ThriftBooks ® and the ThriftBooks ® logo are registered trademarks of Thrift Books Global, LLC